- 移动端

武汉华美生物工程有限公司CUSABIO®品牌商
15 年
手机商铺
- NaN
- 0
- 0
- 2
- 2
推荐产品
公司新闻/正文
AI预测高分,实验却“翻车”?验证AI设计抗体,必须搞清这4个问题
4 人阅读发布时间:2026-11-11 09:30
假设一个抗体项目拿到200条AI推荐序列,首轮只能合成20条。排序靠前的候选个个看着都像样——结构预测挑不出毛病,界面接触也充足,模型还给出了不错的置信度。可团队真正拿不准的是,这些分数能不能帮他们挑出实验里表现更好的分子。
这些候选到底靠不靠谱,还得实验来回答四个问题:模型排序有没有帮上忙、抗体是不是按设计方式结合的、结合了能不能产生预期功能、性质能不能支撑后续开发。
首轮只能测几条时,模型排序最实际的用处,就是帮有限的名额更可能选中好分子。一项名为AIntibody的AI抗体设计盲测评估了模型挑选候选的能力:在一组相近抗体里挑高亲和力候选,多数方法不比随机选择强;该任务中表现最--好-的方法,挑出来的抗体有一半亲和力高于组内对照,而随机挑的话这个比例是39%[1]。 图1进一步显示,多数送测候选的亲和力未优于组内对照。模型排序是否有用,需要放在这样的实验比较中判断。
这种效率也会随设计起点变化。Dreyer等人做过一个改造已有抗体恢复XBB.1.5结合的实验,同一个流程里,以DXP-604为起点的命中率是54%,换成LY-CoV1404就只有15%[2]。一个项目中取得的命中率,换到另一株抗体上未必能够重现。
因此,判断模型是否适合当前项目,需要看一批候选的整体表现,并与随机或常规筛选比较。最-好-的一个亲和力数值可以展示设计潜力,而整批候选的命中情况,才更能帮助团队估算下一轮实验投入。
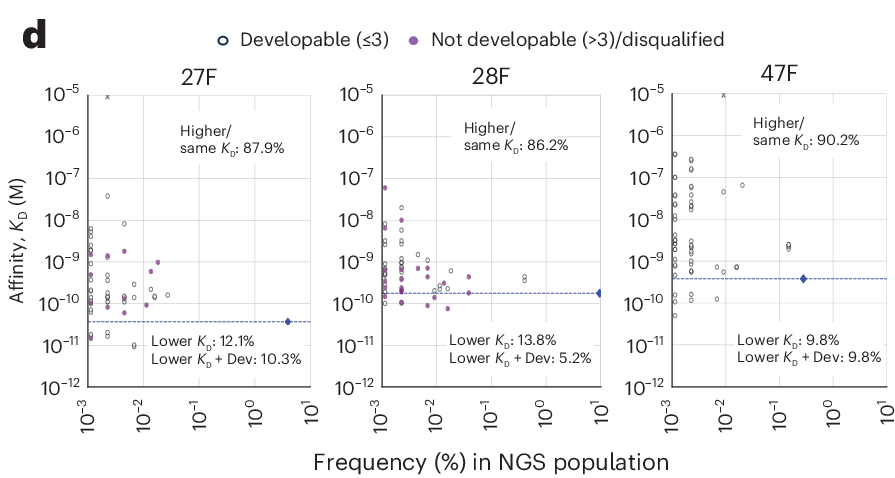
图1.多数 AI 候选未优于组内丰度最高克隆。蓝色虚线表示各组测序丰度最高克隆的实测KD;KD越低,亲和力越高。空心点与紫色实心点区分不同的可开发性评价结果。Fig. 3d, 截取原图局部。
SPR或BLI测到结合后,还需要确认抗体是否识别了预期位置。tFold研究中的H093就是一个例子:它对流感血凝素的亲和力较高,却没有与参考抗体FluA20发生预期竞争,作者猜测它结合在了预设表位之外[3]。
怎样进一步确认结合位置?Germinal研究将实验结构与位点突变结合起来验证,他们对抗PD-L1抗体片段H5做了冷冻电镜,整体结合姿态跟预测接近;把PD-L1上两个预期接触位点换掉后,3株设计抗体的亲和力都掉了。这两个位点刚好就在H5和PD-L1的接触界面上,突变引起的结合变化和结构观察对得上(图2)[4]。
抗原换一种形态,结合结果也可能不同。RFdiffusion研究中,针对HA单体获得的4个候选,在改用天然糖基化HA三聚体检测后,只有1个显示结合。糖链或相邻亚基可能遮住部分结合位点,使抗体更难接近[5]。
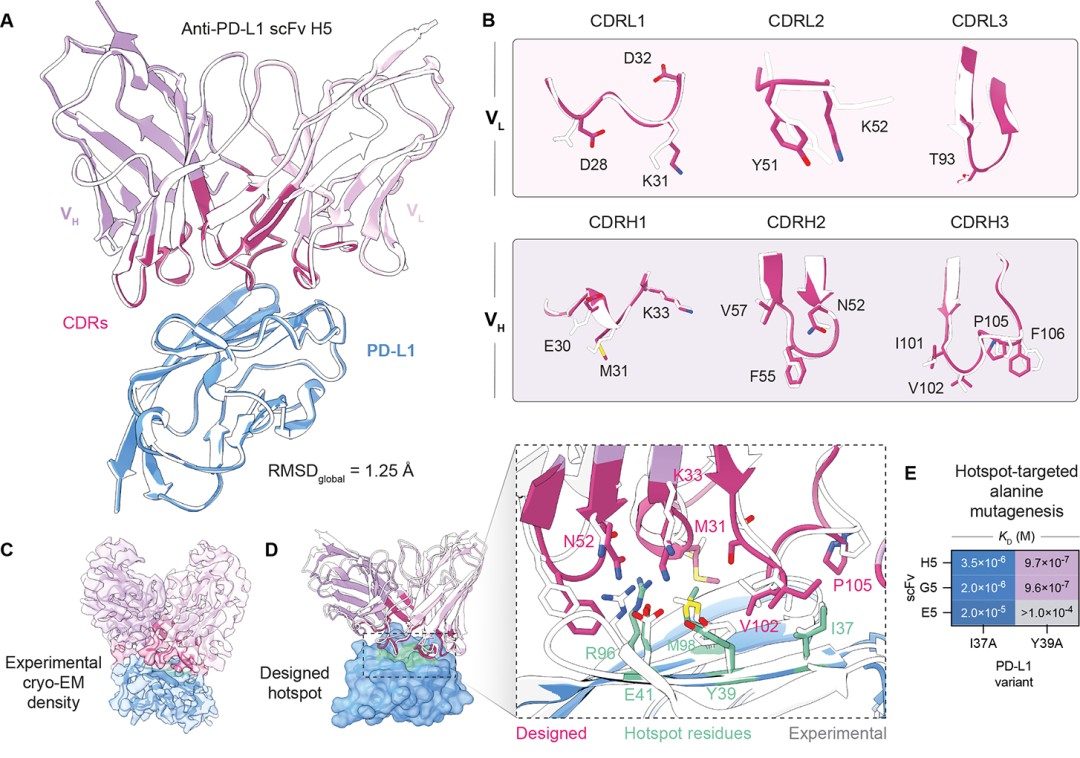
图2.实验结构与位点突变共同支持预期结合位置。A–D: 抗PD-L1抗体片段H5的实验结构、预测模型及局部界面;E: 将PD-L1上的I37或Y39替换为丙氨酸后,3株设计抗体的亲和力下降。Fig. 4A–E,截取原图局部。
前面讨论的结合位置,到了功能验证时就有了更具体的意义。针对RBD的抗体即使结合很强,也未必能妨碍ACE2接近。tFold挑了5株高亲和力RBD抗体测,只有2株有效阻断了RBD与ACE2的相互作用[3]。亲和力测定后接上竞争实验,才看出了这些候选在阻断能力上的差别。
受体竞争有助于解释作用机制,是否抑制了病毒感染,还需在细胞中观察。Hie等人在优化C143抗体后,用假病毒实验检测了这一效果:优化变体对Beta和D614G的中和效力分别提高约32倍和19倍(图3b)。该研究中15个抗体变体的结合改善与中和效力改善总体呈正相关(图3c)[6]。
在受体信号调控中,还要分清结合后产生的是激活还是抑制。Harvey等人研究AI辅助筛选得到的MRGPRX2纳米抗体时,分别检测了抗体单独加入,以及抗体与已知激动剂先后加入两种情况。3株纳米抗体自身都未引起肥大细胞脱颗粒,但能抑制激动剂诱导的脱颗粒,由此确认了它们的拮抗作用[7]。
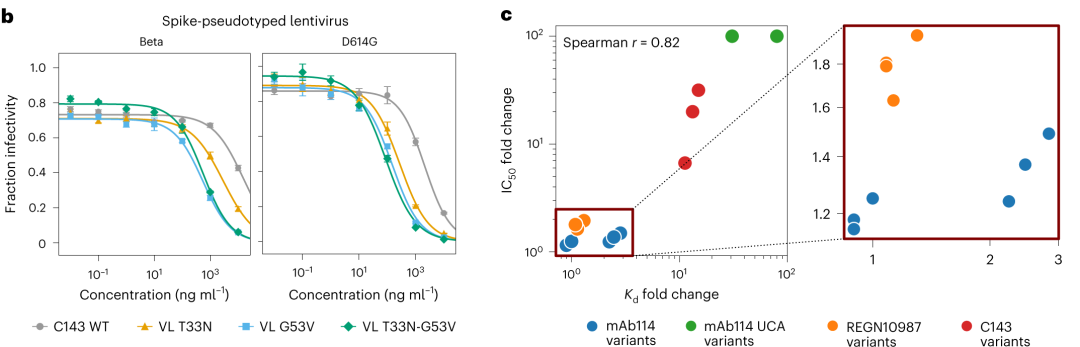
图3.C143优化变体的假病毒中和效力提高。b:与亲本C143 WT相比,优化变体在更低浓度下即可降低假病毒感染;左、右分别为Beta和D614G; c:15个抗体变体的结合与中和改善总体呈正相关。Fig. 3b、c, 截取原图局部。
为了让抗体更好制备而做的修改,有时会引入新问题。Germinal研究里的抗IL-3分子D2,把半胱氨酸换成丝氨酸之后,单体表达和靶点结合都恢复了,可D2Ser的多反应性分数从原始D2的0.6%升到了40.6%(图4)[4]。本来是解决表达问题,又带来了非特异结合的顾虑。
也有候选在结合增强的同时,稳定性有所改善。AbOptimizer优化siltuximab时,Ab3-4在IL-6结合ELISA中表现更好,热变性温度Tm也提高了约4 °C。不过,同批其他变体的Tm有的接近亲本,有的反而下降[8]。仅看结合测定,很难看出这批变体在稳定性上的差别。
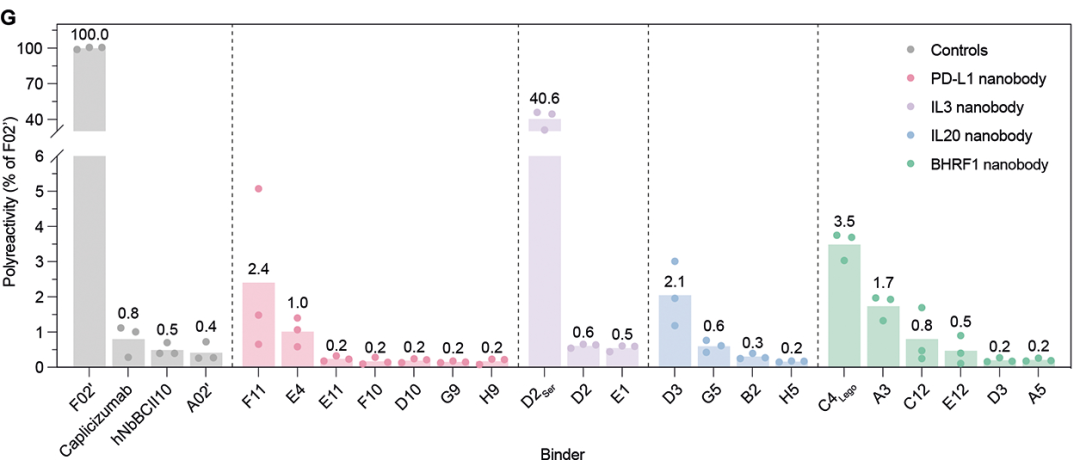
图4.D2Ser的多反应性高于原始D2。图中D2与D2Ser的分数分别为0.6%和40.6%,采用多特异性试剂检测,以阳性对照F02′归一为100%。Fig. 3G, 截取原图局部。
AI设计把更多候选带到实验台前,实验的任务也随之变得更具体:确认排序有没有帮助、识别方式是否实现、功能收益有多大,以及收益是否伴随新的代价。将差异定位到具体环节,比笼统判断“AI设计成功或失败”更有用;这样的结果才能用来指导下一轮设计,也能帮着决定当前候选留不留。
参考文献:
[1]Erasmus MF, et al. A blinded, prospective benchmark of in silico antibody discovery anchored to experimental affinity and developability. Nature Biotechnology. 2026.
[2]Dreyer FA, et al. Computational design of therapeutic antibodies with improved developability: efficient traversal of binder landscapes and rescue of escape mutations. mAbs. 2025;17(1):2511220.
[3]Wu F, et al. De novo design of epitope-specific antibodies via a structure-driven computational workflow. Nature Communications. 2026;17:625.
[4]Mille-Fragoso LS, et al. Efficient generation of epitope-targeted antibodies with Germinal. Nature Biotechnology. 2026.
[5]Bennett NR, et al. Atomically accurate de novo design of antibodies with RFdiffusion. Nature. 2026;649:183–193.
[6]Hie, B.L., Shanker, V.R., Xu, D. et al. Efficient evolution of human antibodies from general protein language models. Nat Biotechnol 42, 275–283 (2024).
[7]Harvey EP, Smith JS, Hurley JD, et al. In silico discovery of nanobody binders to a G-protein coupled receptor using AlphaFold-Multimer. Nature Communications. 2026;17:5641.
[8]Qiu, M., Wang, Z., Liu, X. et al. Multiproperty optimization of therapeutic antibodies through sequence editing via large language model and reinforcement learning. Nat Commun 17, 11039 (2026).Nature Communications. 2026;17:11039.